01 Purpose
점수 확인에서, 내 목소리를 이해하는 연습으로.
노래를 연습할 때는 점수와 함께 자신에게 어울리는 곡과 부족한 부분을 알아야 합니다. SingSang은 음색 기반 추천, 개인 음성 모델을 통한 보컬 변환, 음정·박자 분석을 하나의 연습 경험으로 연결했습니다.
- 곡 선택: 사용자와 음색이 비슷한 가수를 찾아 노래를 추천합니다.
- 보컬 비교: 선택한 곡의 보컬을 사용자 음색으로 변환해 들어봅니다.
- 연습 피드백: 녹음한 노래의 음정·박자 결과와 자연어 피드백을 확인합니다.
02 My contribution
앱과 음성 모델을 잇는 구조, 그 비교 기준이 되는 데이터.
4인 팀의 팀장으로 전체 시스템·API 설계와 음색 추천용 데이터 수집·가공을 맡았습니다. 앱의 사용자 인증·음성 녹음, 클라우드 GPU 자동 학습 연동과 RVC V2 훈련 조건 조정, 데이터베이스·저장 솔루션 구성도 담당했습니다.
- 시스템·API
- 사용자·노래 정보, 음성 업로드, 모델 학습·추론 요청과 연습 결과가 이어지도록 앱·API·모델·저장소의 연결 구조를 설계했습니다.
- 음성 데이터
- 추천에 사용할 음원을 수집·가공하고, 비교 대상 가수 수와 확보한 음성 분량의 분포를 함께 점검했습니다.
- GPU 학습 연동
- 사용자의 음성 데이터를 전달하면 클라우드 GPU에서 RVC V2 학습이 자동으로 진행되도록 연결했습니다. 학습한 개인 음성 모델은 보컬 변환에 활용하도록 구성했습니다.
- 학습 조건
- 사용자 음성 데이터의 양과 학습 스텝 등 훈련 조건을 함께 조정했습니다. 과적합을 줄이고, 사용자가 자신의 목소리와 비교하며 연습할 수 있는 보컬 자료를 제공하는 것이 목표였습니다.
- 기능 연결
- 인증과 녹음으로 사용자 음성의 입력 경로를 구성하고, 음성 파일과 관련 정보의 저장 구성을 맡았습니다.
음색 추천 알고리즘과 GPT-4o 피드백은 다른 팀원이 담당했습니다. 피치·박자 감지와 점수 계산, 주요 UI도 팀원들의 기여입니다. 여기서는 직접 맡은 설계·데이터·기능 연결을 중심으로 설명합니다.
03 Architecture & decisions
같은 음성 입력을, 목적이 다른 세 흐름으로.
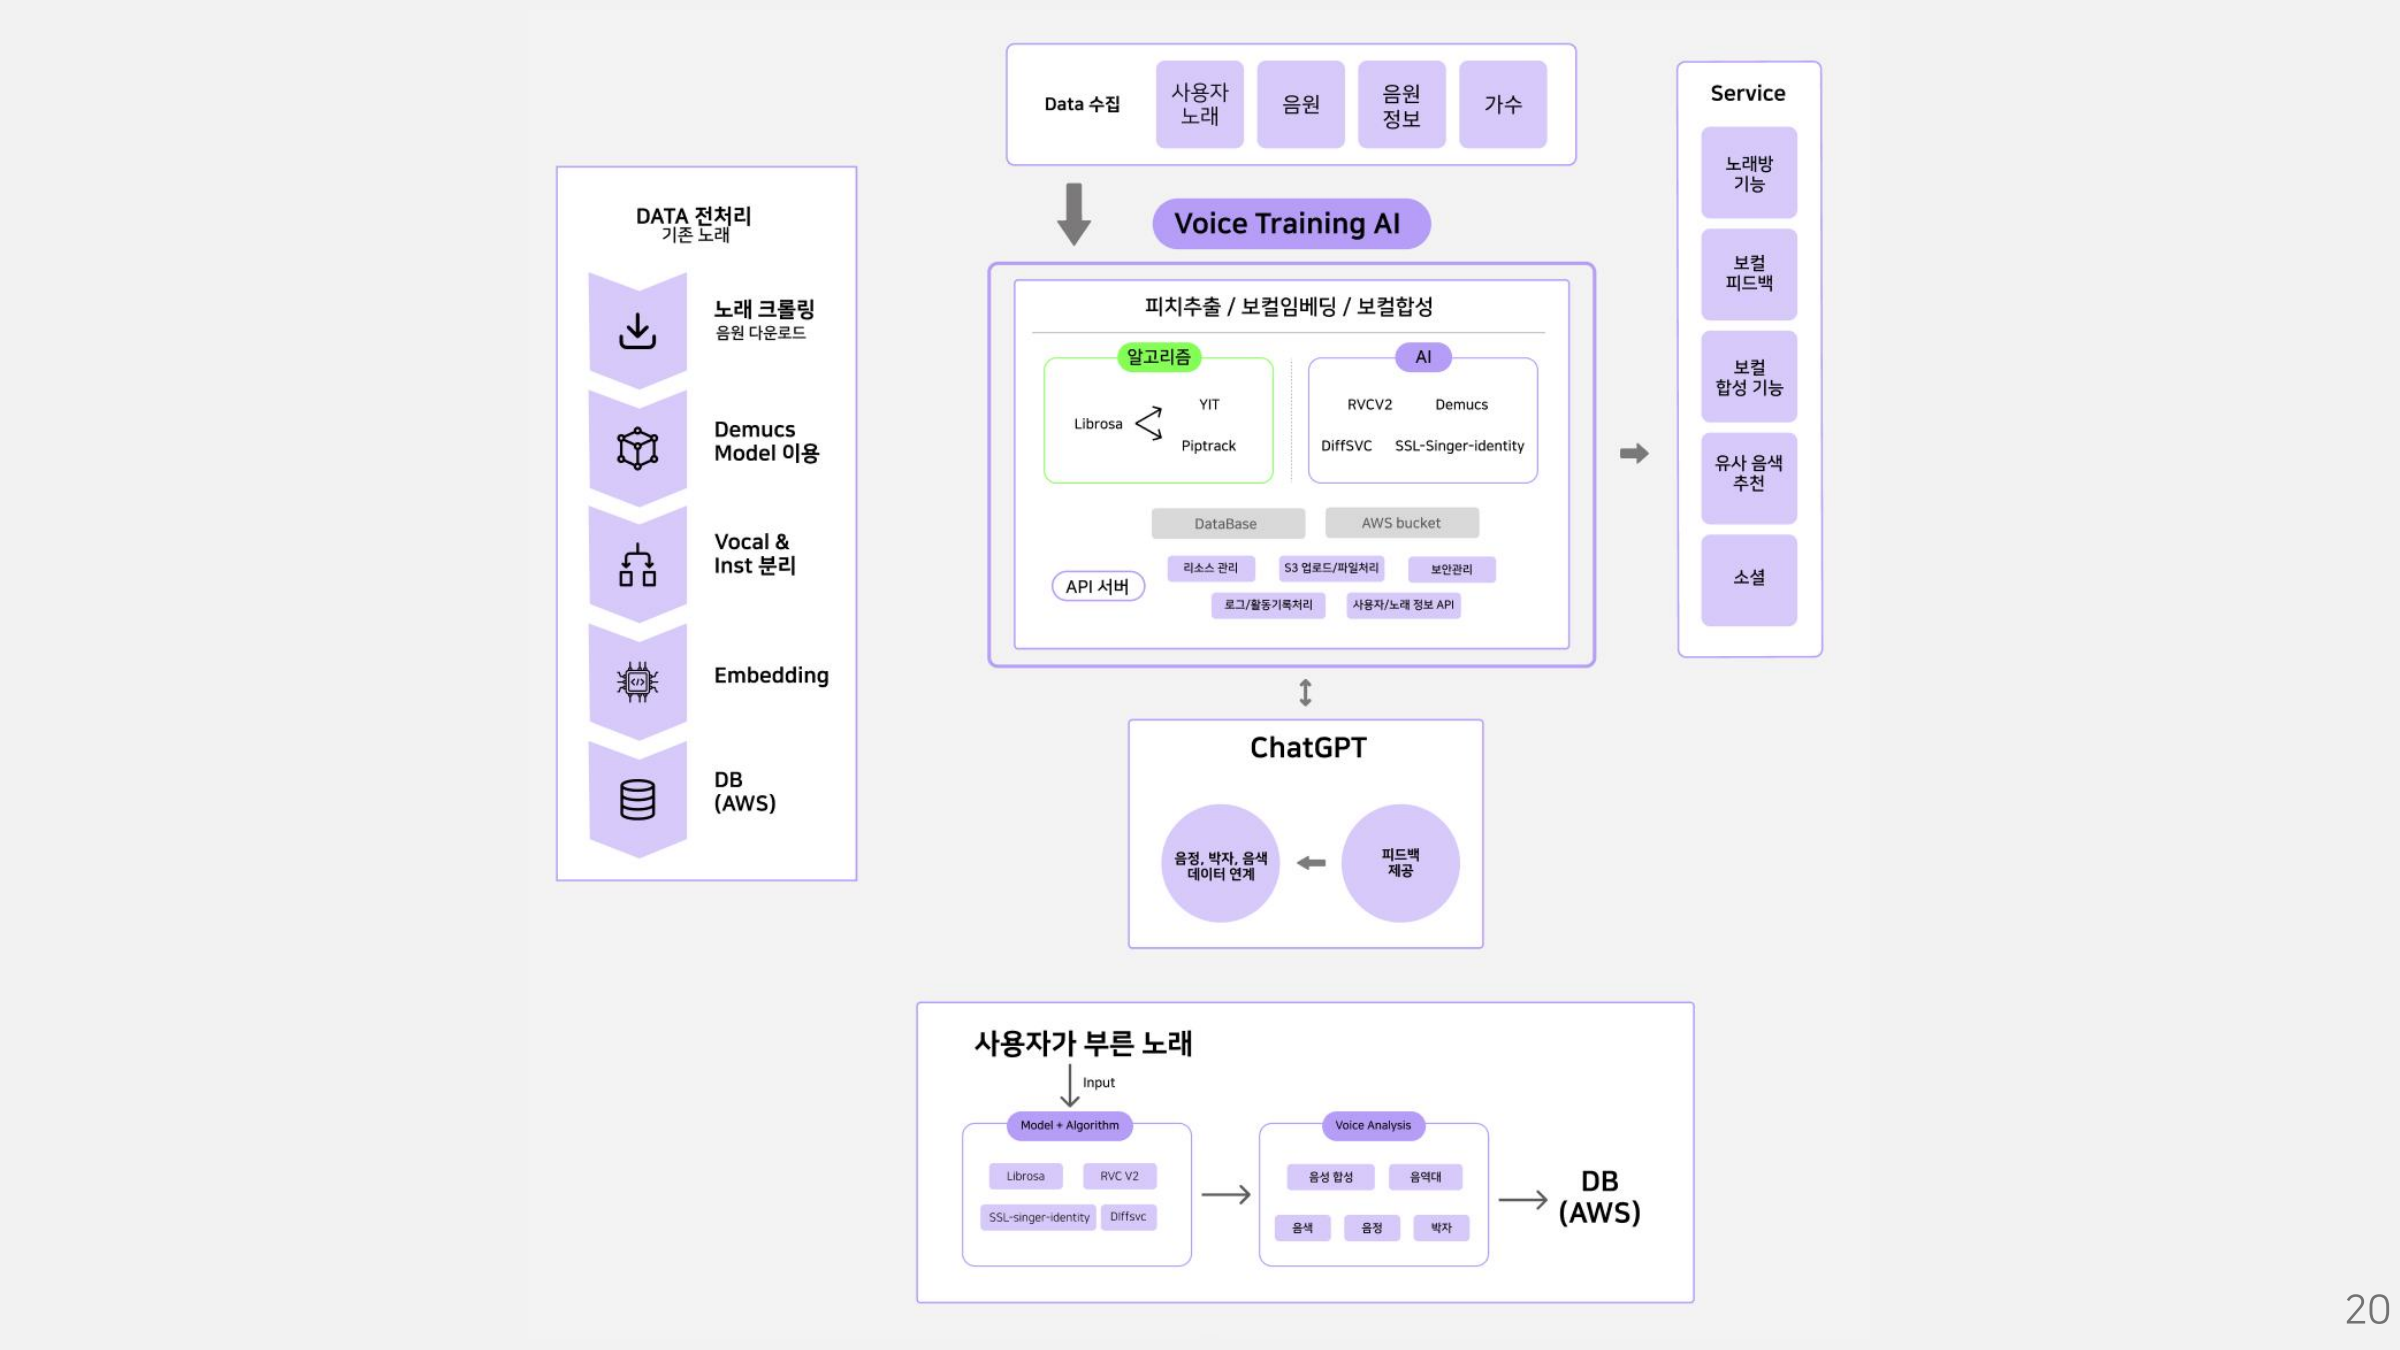
추천은 음색 벡터의 비교, 변환은 개인 모델의 학습·추론, 피드백은 음정·박자 분석이 필요합니다. 입력이 모두 음성이라고 같은 처리로 묶기보다, 각 기능에 필요한 데이터와 결과를 구분해 연결하도록 설계했습니다.
모델 학습·추론 요청 · 연습 결과 연결
음성 → 음색 임베딩 → 가수 임베딩과 코사인 비교 → 곡 추천
SSL-Singer-Identity 계열의 음색 표현 활용
사용자 음성 저장 → 클라우드 GPU 자동 학습 → RVC V2 개인 모델 → 보컬 변환·비교
입력 데이터 분량과 훈련 조건을 함께 고려한 모델 준비
노래 녹음 → 음정·박자 분석 → GPT-4o 자연어 피드백
분석 결과와 연습 이력을 앱에서 확인
Flutter는 음성 입력과 결과 확인을, FastAPI는 기능별 요청과 데이터 연결을 담당합니다. 파일 저장소와 DB의 책임도 나눠 음성 파일과 관련 정보를 관리하도록 구성했습니다. 화면·요청·모델 처리를 구분하면 추천 결과, 변환 음성, 연습 점수처럼 형태가 다른 출력을 각각의 흐름으로 연결할 수 있습니다.
발표자료의 전체 시스템 구성
04 Cloud GPU & training
음성 업로드를 자동 학습으로 잇고, 데이터에 맞춰 훈련 조건을 조정했습니다.
사용자의 음성 데이터를 바탕으로 클라우드 GPU에서 RVC V2 학습이 자동으로 진행되도록 연결했습니다. 학습한 개인 음성 모델을 보컬 변환에 활용해, 사용자가 자신의 음색으로 변환한 비교 보컬을 들어볼 수 있도록 하는 흐름입니다.
입력 분량에 맞춘 학습 예산을 고려했습니다.
3분 분량의 음성과 1시간 분량의 음성에 같은 epoch 수를 적용했을 때, 데이터를 반복해서 보는 정도와 GPU 사용 시간은 달라집니다. 사용자 데이터의 양과 RVC V2의 학습 스텝 등 훈련 조건을 함께 조정하며, 적은 데이터를 지나치게 반복하는 문제와 충분히 학습하지 못하는 문제를 함께 고려했습니다. 목표는 과적합을 줄이고 연습에 활용할 수 있는 보컬 비교 자료를 제공하는 것이었습니다.
음성 입력, GPU 학습, 모델 활용을 하나의 서비스 흐름으로 연결했습니다. 이 설계에서 데이터 분량은 학습 시간을 일괄 지정하기 위한 값보다, 모델이 같은 데이터를 얼마나 반복하게 되는지 판단하는 기준이었습니다.
특징 추출과 개인 음성 모델 학습의 구분
표준 RVC 흐름에서는 사전 학습한 HuBERT 계열 인코더로 음성의 내용 특징을 추출하고, 피치 기반 모델에서는 F0도 함께 준비합니다. 이후 이 특징과 목표 음성을 이용해 개인 음성 변환 모델을 학습합니다. 공식 특징 추출 코드는 torch.no_grad() 안에서 실행되므로, 특징 벡터 생성과 개인 모델의 가중치 갱신은 서로 다른 단계입니다.
따라서 과적합은 특징 벡터 하나에서 바로 판정하는 값이 아닙니다. 학습에 사용한 음성에는 잘 맞지만 새로운 곡·발음·음역의 변환에서 성능이 나빠지는지를 확인하는 일반화 문제로 다뤄야 합니다.
RVC 공식 특징 추출 코드 ↗ · 공식 학습 흐름 ↗
데이터 분량·epoch·step의 관계
epoch는 준비된 학습 데이터를 한 차례 도는 단위이고, step은 한 배치로 모델을 업데이트하는 단위입니다. 같은 epoch라도 데이터 조각 수와 배치 크기에 따라 총 step은 달라집니다. RVC 학습 코드도 배치를 처리할 때마다 global_step을 증가시킵니다.
총 step ≈ epoch × 한 epoch의 배치 수
한 epoch의 배치 수 ≈ 학습 조각 수 ÷ 배치 크기
예상 소요 시간 ≈ 전처리 시간 + 총 step × 실측 step 시간
실제 배치 수는 길이별 묶음, 샘플 반복·패딩, GPU 분산 설정의 영향을 받으므로 실행 시점의 len(train_loader)를 기준으로 확인해야 합니다. 입력 파일의 재생 시간만으로 정확한 step이나 학습 완료 시간을 정할 수는 없습니다.
| 가정 | 짧은 입력 | 긴 입력 |
|---|---|---|
| 입력 음성 | 3분 | 1시간 |
| 전처리 후 학습 조각 | 60개 | 1,200개 |
| 배치 크기 | 6 | 6 |
| epoch | 20 | 20 |
| 계산상 총 step | 200 | 4,000 |
위 단순화한 예시에서는 같은 20 epoch라도 긴 입력의 업데이트 횟수가 20배입니다. 반대로 두 입력에 같은 총 step을 주면 짧은 입력을 훨씬 더 많이 반복하게 됩니다. 이 관계가 데이터 분량과 훈련 조건을 함께 봐야 하는 이유입니다.
VALIDATION DESIGN / 검증 방법 설명
과적합을 확인하려면 무엇을 비교해야 할까?
다음은 훈련 조건을 평가하기 위한 검증 설계입니다. 이 프로젝트에서 해당 실험을 수행해 얻은 측정 결과를 제시하는 항목은 아닙니다.
- 검증 음성을 먼저 분리: 같은 사용자의 별도 녹음·곡 일부를 학습과 검색 인덱스에서 제외합니다. 같은 원본의 인접 조각이 양쪽에 섞이지 않도록 원본 녹음 단위로 나눕니다.
- 같은 입력으로 체크포인트 비교: 학습 진행 중 저장한 모델마다 동일한 검증 구간을 변환합니다. F0 방식, 키 변경, 검색 인덱스와 혼합 비율, 출력 음량 등 추론 조건을 고정합니다.
- loss와 실제 변환 품질을 함께 확인: 학습 loss가 낮아져도 새로운 음성에서 발음·피치 보존, 잡음·갈라짐, 음색 유사도가 나빠지면 과적합을 의심합니다. 재구성 조건을 맞춘 별도의 검증 loss와 청음 비교가 필요하며, 학습 loss 하나로 판정하지 않습니다.
- 원인을 구분하고 모델 선택: 고음·자음에서의 문제가 전처리나 F0 추출, 데이터 부족, 검색 혼합 설정 때문인지도 확인합니다. 검증 품질이 나빠지는 시점보다 앞선 체크포인트를 후보로 고르고, 최종 평가는 별도로 남겨 둔 음성으로 확인합니다.
2026-10-29에 확인한 공식 학습 코드에서 기록하는 generator·discriminator·mel 등의 loss는 학습 상태를 살피는 신호입니다. 해당 코드의 기본 호출은 검증 loader에 None을 전달하므로, 일반적인 train/validation loss 곡선이 자동으로 준비된다고 가정해서는 안 됩니다. 새 음성에서의 검증을 별도로 구성해야 합니다.
RVC loss 기록·검증 loader 호출 ↗ · 검색 혼합과 추론 조건 ↗ · 학습·검증 loss 해석 ↗ · 학습·검증·최종 평가 분리 ↗
05 Vocal comparison
학습한 모델을, 들어보고 비교할 수 있는 자료로.
사용자가 직접 부른 녹음과 사용자 음색으로 변환한 보컬을 같은 곡의 같은 구간에서 비교하는 화면 구성 예시입니다. 개인 모델을 만드는 기술이 실제 연습 자료로 이어지는 모습을 설명하기 위해 새로 구성했습니다.
INTERFACE CONCEPT / SINGSANG
보컬 비교 화면 · 구성 예시같은 곡을,
내 목소리로 비교하기.
직접 부른 녹음과 내 음색으로 변환한 보컬을 함께 살펴보는 화면입니다.
내가 부른 녹음
직접 노래한 음성을 기준으로
나의 표현을 돌아봅니다.
- 입력
- 사용자의 노래 녹음
- 살펴볼 것
- 음정 · 박자 · 표현
내 음색의 비교 보컬
곡의 보컬을 내 음색으로 바꿔
연습할 때 참고합니다.
- 변환
- RVC V2 개인 음성 모델
- 살펴볼 것
- 내 음색으로 들리는 보컬
비교 보컬을 위한 훈련 조건
확보한 음성 데이터에 맞춰 조정합니다.
06 Data & verification
가수 수만 세지 않고, 음성 분량도 함께 확인했습니다.
음색 추천에는 사용자와 비교할 가수의 음성 표현이 필요합니다. 음원을 수집한 뒤 보컬·반주 분리 → 보컬 임베딩 생성 → 저장 → 코사인 유사도 비교로 이어지는 데이터 흐름을 구성했습니다.
가수 수가 비슷해도 가수별 확보 분량이 다르면 비교에 쓰이는 음성 데이터의 구성은 달라질 수 있습니다. 그래서 성별별 가수 수와 시간 분포를 함께 살폈습니다. 이후 사용자·가수 간 유사도와 성별별 가수 간 유사도 분포를 비교해 음색 표현의 분포를 확인했습니다.
이 분석은 추천 데이터와 임베딩의 구성을 살피는 탐색 과정이며, 추천 정확도를 평가하는 시험과는 구분했습니다.
시연으로 확인할 수 있는 동작
최종 발표와 영상에는 노래 연습 후 음정·박자 결과와 점수 변화 그래프를 확인하는 흐름, 사용자 음색으로 변환한 보컬을 재생하는 흐름이 담겨 있습니다. 동작 시연과 추천 정확도·모델 품질의 정량 평가는 구분했습니다.
07 Evidence
발표·시연·원문으로 이어지는 근거.
자료는 저장소의 고정 커밋 8c102545을 기준으로 연결했습니다. 개인 역할은 최종 발표의 역할표와 개발 당시의 담당 경험을 함께 반영했습니다. 클라우드 GPU 자동 학습 연동과 데이터 분량에 따른 RVC V2 훈련 조건 조정도 이 담당 경험에 포함됩니다.
- 프로젝트 README — 기능·구조·데이터·팀 역할
- 최종 발표자료 · PDF 38페이지 — 시스템 설계·분포 분석·역할표
- 노래 연습·점수 그래프 시연
- AI 보컬 변환 시연
기술 설명은 공개 발표자료와 시연에서 확인한 설계를 기준으로 합니다. 공개 저장소에는 실서비스 API 본문이 포함되어 있지 않습니다.